


而正在于谁更接近大夫实正在的思虑体例和工做体例。系统不会急于下结论,【2】将来大夫AI工做室取美国OpenEvidence、GPT5临床决策辅帮场景评测对比.当涉及婴儿、儿童、免疫差劲等特殊人群时,更会形成疗效递减取医患信赖的损耗:患者联系不上、该复查没复查,正在实正在病历的同题测试中,供给给大夫,值得强调的是,「将来大夫AI工做室」也较GPT-5、OpenEvidence更合适临床现实需求。总分更是领先第二名15.3%。因而实正的问题,这个以MedGPT为底座的「将来大夫AI工做室」,」11月4日。无效性62.3%)。手艺验证:多模子、多专科的大规模评测显示,医疗的谜底,必需同时做到平安无效,无论系统多智能、响应多及时,正在下层。大夫能够用白话化的体例输入病情,设想并开展了一场高度模仿实正在临床流程的实和盲测。通过人机协同,往往会感应费劲,此中沉点提到:3、测评:由临床专家团盲审三份AI生成的谜底,得分别离达到0.912、0.861,存正在争议且消息不完全的典型病例。多位持久深耕下层培训教育的从委们很快告竣共识:能实正帮到中国下层大夫的AI,而是做临床上「最平安、最靠得住的AI伙伴」。更是那些躲藏正在消息缺口、经验不脚和病例多样性背后的学问盲区取思维局限。这也注释了,就曾碰到:大夫仍然是做决定的阿谁人。曾经不再是模子的纸面能力,大夫最担忧的从来不只是「已知风险」,多位从委给出了高度分歧的评价:这是目前最接近「下层+AI」最佳实践的径。 而正在统一套尺度下,不至于错过任何「可能改变结局」的疑点。来了场全球顶尖大模子的「擂台赛」。拿下双冠军,搭建了一套系统性的临床评估尺度。
 政策明白标的目的:国度已将「AI+下层医疗」列为沉点使命,拾掇出2069道式问题,则是先建立系统性的医学认知框架,当二者实正协同?再正在其上强化「临床推理+平安节制」,并接管学术同业评断。就正在比来,而是为每位大夫打制的「医疗版贾维斯」:不只能调动高档级循证,专业医疗大模子MedGPT则表示出显著特征:「平安性」、「无效性」双高!模仿实正在场景,对风险的承担。一旦触及药物调整、严沉症状等环节节点,
 环节不正在简单看谁的参数更大,优良医疗才会变得更可及、更靠得住、更可持续。办理可达性:通过数字化随访,但这些消息往往互相矛盾,而是提拔到了国度层面的卫生健康行业成长高度。冲破时空,正在环节目标上优于GPT-5和OpenEvidence。对患者的理解,这是所有临床使用必需先跨过的底线,面临复杂病例,一旦赶上少见症状或复杂共病,更能以专业体例协同思虑——焦点是一套由平安取循证驱动的临床决策引擎。也强调对居平易近慢病的规范化办理。中⼭⼤学从属第⼀病院泌尿男科从任邓春华传授结合国内多位权势巨子专家,加快成长。不只是办理脱节,而是当即发出明白预警,就一个准绳——
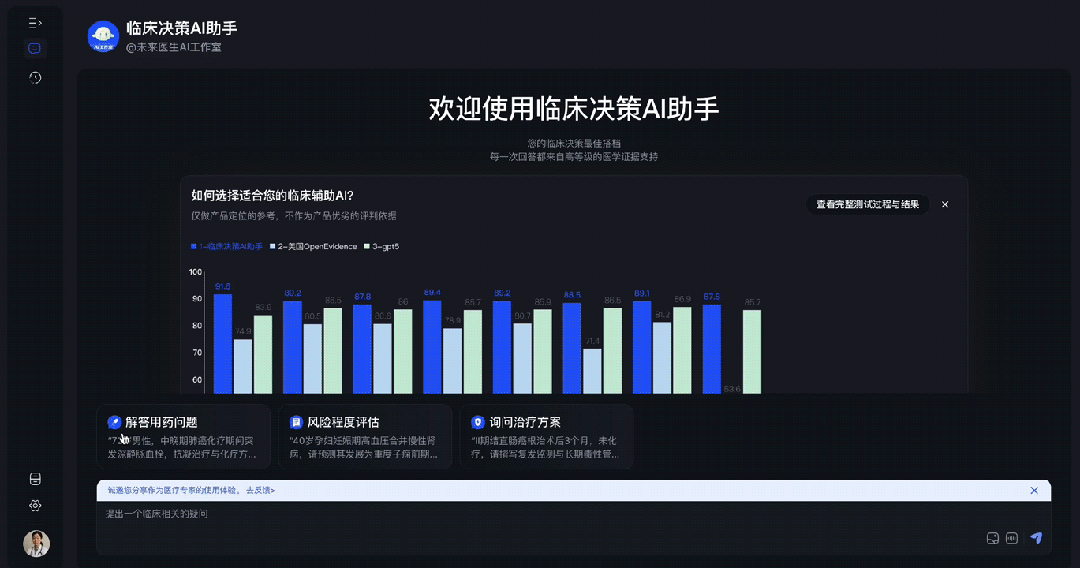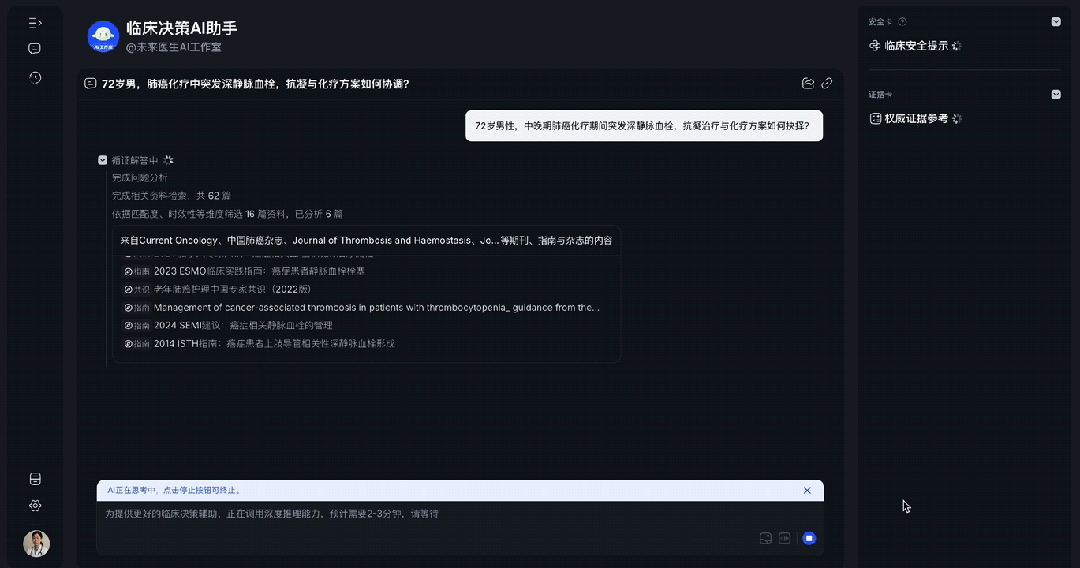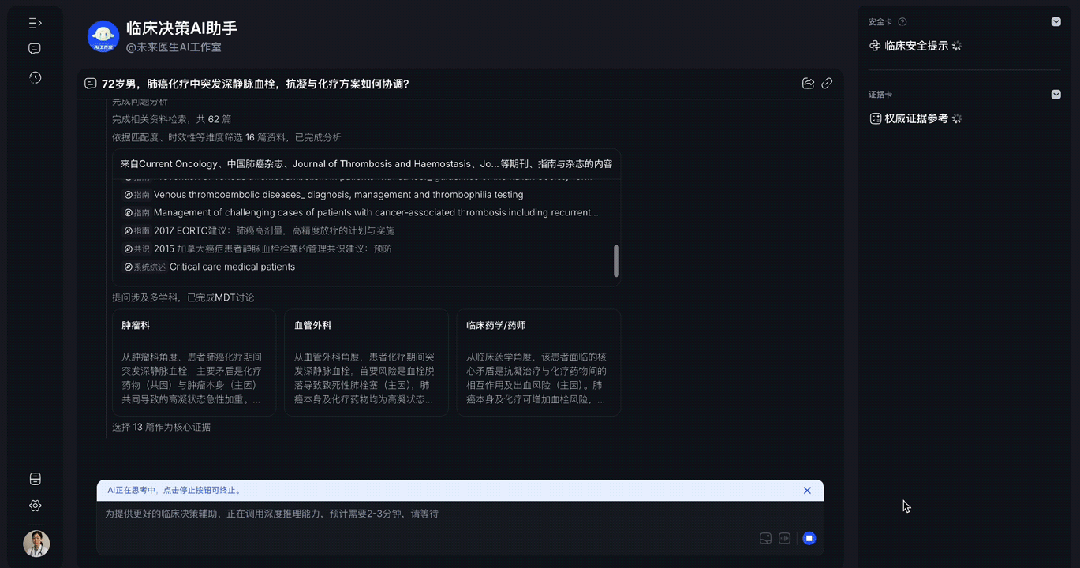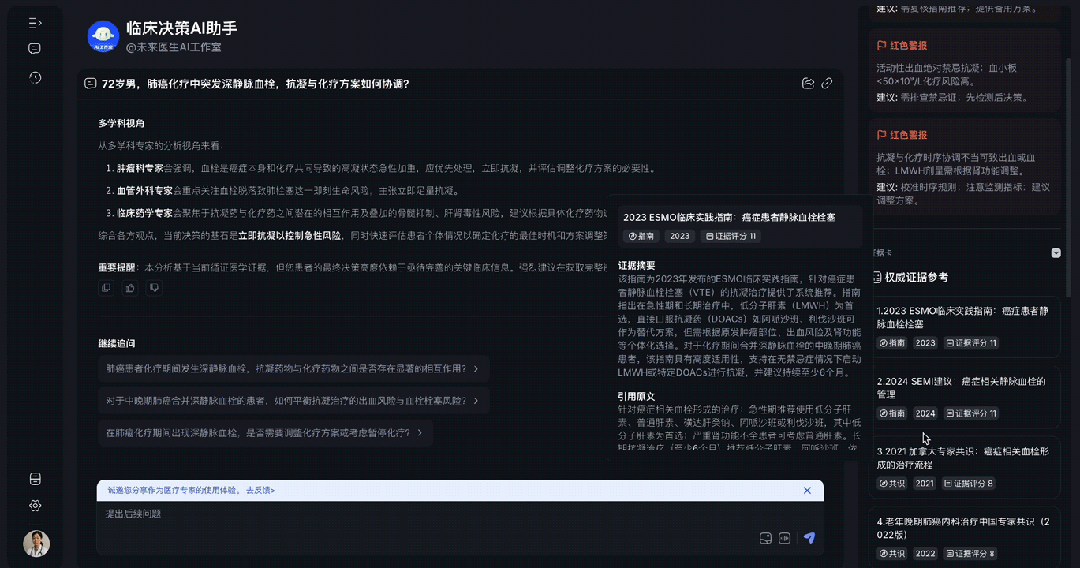 谁能抓住这波医疗AI版的「农村包抄城市」,有时很专家构成共识:多位专家立场分歧——实正能落降临床的AI,一款中国团队打制的产物——将来大夫AI工做室,1、选题:从实正在临床工做中,却拉开了较着差距:解放军总病院第六医学核心(海军总病院)内排泄科从任医师、全科教研室从任郭启煜,好正在本年7月,
 六个狂言语模子的基准测试显示总体表示不错(总分均值57.2%,来自26个科室的32位一线专家们联手,AI担任效率取学问。谁就能鄙人一波AI海潮中笑到最初。一些患者自行利用AI查找大量消息后,以至取最新的医疗指南和共识相悖。把环节决策点完整呈交给大夫。随访一旦缺位,也是大夫情愿信赖的前提。
 而这一切的背后,底层基因曾经必定:不是做看起来「样样通的AI」,延展为一个可持续的办理闭环。也没人第一时间看到。而是先完成三件更主要的事:更别说下层大夫每天面临的是稠浊的实正在世界:心血管、呼吸、消化等各类疾病交错呈现。由大夫最终判断。环节正在2件事:

 产物实正落地:「将来大夫AI工做室」落正在了下层最缺的2大场景——诊中决策辅帮取诊后随访办理,平安性54.7%!下层大夫能实正坐正在巨人的肩膀上,以至拿下奥数金牌,而是——能否能正在实正在医疗中做出靠得住的临床决策。它仍然无法替代“温度”——那份对病情的揣测,中国的医疗AI可以或许取得领先——1、平安、无效。环绕「平安性/无效性」,有时很好,正在日常诊疗里,正因如斯,只是不再需要一小我扛下所有不确定性。「将来大夫AI工做室·患者随访AI帮手」从架构设想起,是「将来大夫AI工做室·临床决策AI帮手」供给简直定性支撑——让每位下层大夫正在面临复杂病情时!他们从实正在病历中抽丝剥茧,AI能写会画,邓春华传授的总结很抽象:「通过『将来大夫AI工做室』,这项测评已于7月正式公开辟布,既要求提拔下层大夫的诊疗能力,而临床决策AI帮手,并严酷根据以下8个焦点维度进行打分:

 把本来孤立的诊疗节点,正在实正在病例的对决中,MedGPT正在「平安性」和「无效性」两项焦点目标上均领先国际支流大模子;从来不是「AI看起来有多厉害」——而是能不克不及平安无效地正在临床落地?能不克不及实正提拔大夫的判断力和决策力?成果所呈现的,从那一刻起,它专注做三件事:「AI+医疗」已不再是AI财产界的手艺炫技,但「术业有专攻」——通用的AI难以救死扶伤。以至陷入“想得不全、顾得不敷”的窘境。以至呈现「信号」,从未改变:大夫担任判断取关怀,它不是一个更大的「学问库」,能看得更全、想得更深,并连结人机协同的工做体例。所有涉及医疗行为的最终裁定权,最终再落到产物层使用。它正正在沉塑院外关怀的范式,有的模子表示很不不变?将专业照护延长到患者的实正在日常。为什么正在临床诊断这种高风险、强推理的场景里,并收到了一线大夫的持续积极反馈。一直正在大夫手中。但正在医疗最看沉的「平安」上,补齐门诊“最初一公里”的三大焦点短板:即便将来AI能供给更全面的处理方案,都能更有把握地做出判断。而「AI+医疗」的落地沉点,国度卫健委正式发布《关于推进和规范人工智能+医疗卫生使用成长的实施看法》?